- 公開日
- 最終更新日
S3のデータをAmazon Managed Grafanaで可視化してみた(前編:Athena接続まで)
この記事を共有する


目次
皆さんこんにちは!パーソル&サーバーワークスの小澤です。
システムを運用していると、アクセスログやイベントデータが S3 にどんどん溜まっていきます。データはあるのに、今どうなっているのかパッと見て分からない。そんな経験はないでしょうか。
S3 のデータは Athena を使えば SQL で調べられますが、その都度クエリを実行するのは手間です。傾向を継続的に見たい、複数の指標を並べたい、チームで共有したいとなると、ダッシュボードにまとめたくなります。
そこで Amazon Managed Grafana の出番です。一度ダッシュボードを作れば、あとは開くだけで最新の状況を確認できます。
今回は、S3 に溜めたアクセスログ風データを、Athena をデータソースにして Amazon Managed Grafana で可視化するハンズオンを、前後編に分けて紹介します。
- 前編(本記事): データの準備から、Grafana に Athena を接続するまで
- 後編: 接続したデータでダッシュボードを作る
はじめに知っておきたい料金の話
Amazon Managed Grafana は無料ではありません。ワークスペースにログインして使うユーザーの人数分、ライセンス料金がかかります。本記事執筆時点(2026年8月)では、次のとおりです。
- 管理者・編集者(Admin / Editor): 1人あたり 月 $9
- 閲覧者(Viewer): 1人あたり 月 $5
課金対象は、その月にログインしたユーザーだけです。料金は変わる可能性があるので、必ず公式の料金ページで最新を確認してください。
つなぐデータソースの種類によっては、上記に加えて料金がかかります。Grafana のデータソースは次の2種類です。
- 組み込みデータソース: 追加料金なしで使える。Athena、PostgreSQL、MySQL、CloudWatch など
- Enterprise データソース: Enterprise プラグインを有効にすると使える。DynamoDB、Datadog、Snowflake など。ライセンス料に加えて、アクティブユーザー1人あたり月 $45 がかかります
今回 Athena を選んだのは、組み込みデータソースで追加料金がかからず、サーバーレスで VPC が不要なため構成をシンプルにできるからです。
今回作成する構成
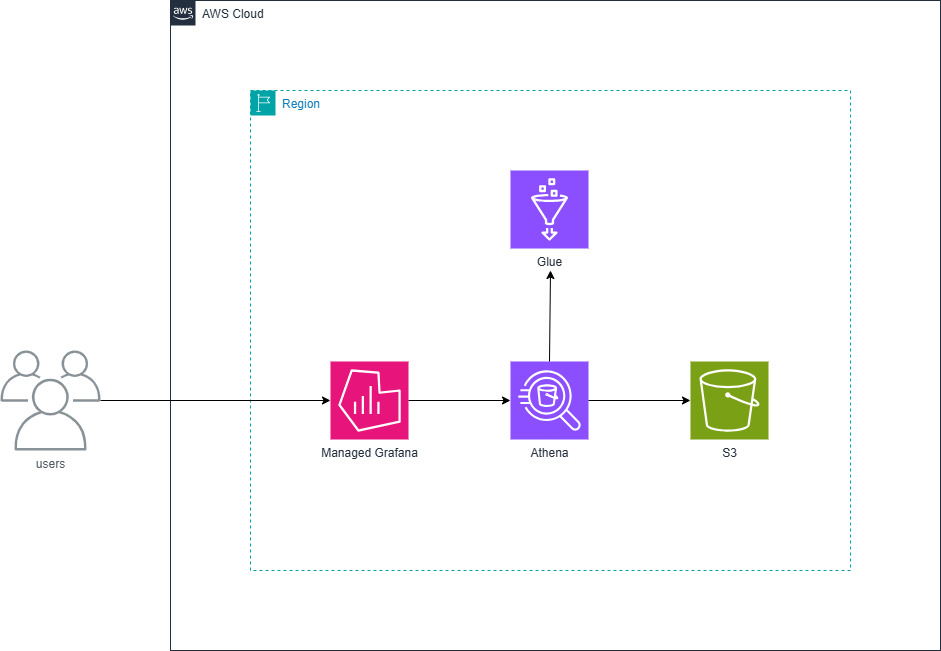
各コンポーネントの役割は次のとおりです。
- IAM Identity Center: Grafana のログイン認証を担う
- Amazon Managed Grafana: データを可視化する基盤
- Amazon Athena: S3 のデータに SQL を投げるサーバーレスのクエリエンジン
- Amazon S3: データ本体を置くデータバケットと、Athena のクエリ結果を書き出す結果バケットの保管先
- AWS Glue データカタログ: S3 のファイルをどんな列として読むかのテーブル定義を保持
Athena も S3 もサーバーレスで VPC が不要なため、ネットワークを構築せずに始められます。
Grafana のパネルを表示するとき、裏では次のように動いています。
1. Grafana が実行したいSQLを Athena に依頼(ワークグループを指定)
2. Athena が Glueカタログを参照し、テーブルの実体がS3のどのフォルダかを解決
3. Athena が S3データバケットから元データを読む
4. Athena がSQLを実行し、結果を一度S3結果バケットにファイルとして書き出す
5. Grafana は Athena のAPI経由でその結果を受け取り、グラフに描画する
ポイントは、Athena がクエリ結果を必ず一度 S3 に書き出すことです。Grafana はそのファイルを直接探しに行くのではなく、Athena の API を通じて結果を受け取ります。
このため S3バケットが2つ登場します。Athena が読むデータバケットと、書き出す結果バケットです。役割が分かれているため別々に用意し、権限もそれぞれ必要になります。
前編の手順の全体像
| ステップ | 作業内容 | 目的 |
|---|---|---|
| 1 | S3バケットを2つ作成し、サンプルデータを配置 | データ置き場と結果出力先を準備する |
| 2 | Athena ワークグループを作成 | Athenaのクエリ実行環境を用意する |
| 3 | Athena でテーブルを作成し、データを確認 | S3のデータをSQLで読めるようにする |
| 4 | Amazon Managed Grafana ワークスペースを作成 | 可視化基盤を用意する |
| 5 | ユーザーを割り当ててログイン | Grafana を使える状態にする |
| 6 | Athena データソースを接続(権限設定含む) | Grafana から S3データをクエリできるようにする |
Step1. S3バケットを2つ作成し、サンプルデータを配置する
今回は役割の違う S3 バケットを2つ用意します。
- データバケット: Athena が読む元データを置く
- 結果バケット: Athena のクエリ結果を書き出す先
1-1. データバケットを作成する
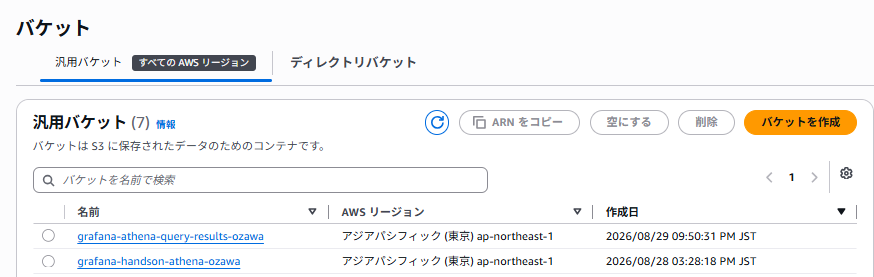
S3 コンソールからバケットを作成を開き、以下のように設定します。基本はデフォルトのままでOKです。
- リージョン: アジアパシフィック(東京)ap-northeast-1
- バケット名: 世界で一意な任意の名前
- パブリックアクセスをすべてブロック: オン
- 暗号化: デフォルトの SSE-S3
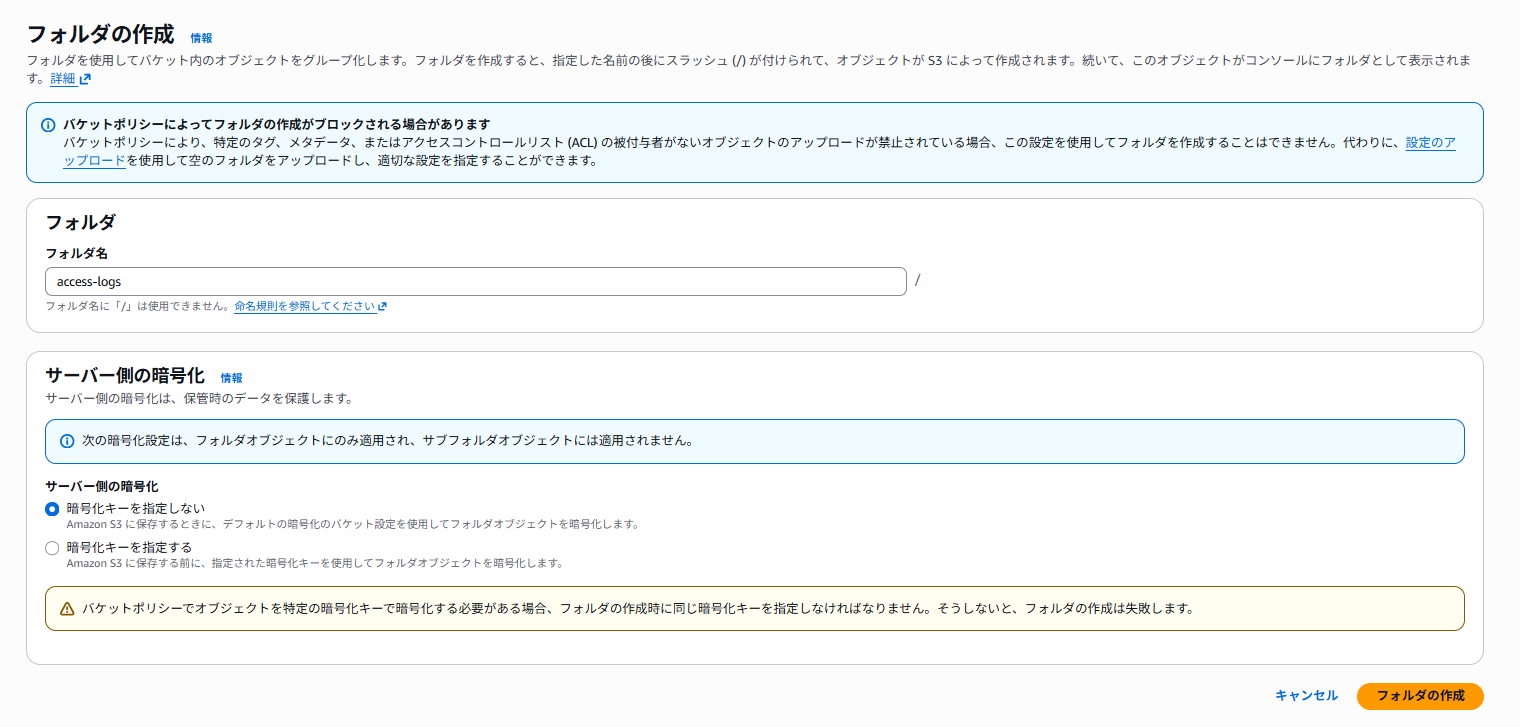
作成したら、バケットの中に access-logs/ フォルダを作ります。ここにサンプルデータを置きます。
1-2. 結果バケットを作成する
同じ手順でもう1つバケットを作成します。以下の条件で作成してください。
- バケット名:
grafana-athena-query-results-で始まる名前 - パブリックアクセスをすべてブロック: オン
中にフォルダを作る必要はありません。
1-3. サンプルデータを生成して S3 にアップロードする
今回は Web アクセスログ風のサンプルデータを使います。ローカルに環境を用意しなくても、ブラウザだけで使える AWS CloudShell で生成できます。
CloudShell を開き(コンソール右上のターミナルアイコン)、次のコマンドをそのまま貼り付けて実行します。直近7日分のアクセスログ風 CSV(access_logs.csv)が生成されます。
サンプルデータ生成スクリプト(クリックで展開・約50行)
python3 - << 'PYEOF'
import csv, random
from datetime import datetime, timedelta, timezone
DAYS = 7
BASE_PER_HOUR = 120
PATHS = [("/",0.25),("/login",0.10),("/search",0.15),("/products",0.15),
         ("/products/detail",0.12),("/cart",0.08),("/checkout",0.05),
         ("/api/users",0.05),("/api/orders",0.03),("/admin",0.02)]
METHODS = ["GET","GET","GET","GET","POST","PUT","DELETE"]
REGIONS = ["ap-northeast-1","us-east-1","eu-west-1","ap-southeast-1"]
def wpath():
    r=random.random(); c=0.0
    for p,w in PATHS:
        c+=w
        if r<=c: return p
    return PATHS[0][0]
def pstatus(path,hour):
    err=0.03
    if 2<=hour<=4: err+=0.06
    if path in ("/checkout","/api/orders"): err+=0.04
    if path=="/admin": err+=0.02
    r=random.random()
    if r<err*0.5: return random.choice([500,502,503])
    if r<err: return random.choice([400,401,403,404])
    return random.choice([200,200,200,200,201,204,301])
def platency(path,status):
    base=60
    if path in ("/search","/checkout","/api/orders"): base=180
    if path=="/products/detail": base=120
    v=random.gauss(base,base*0.4)
    if status>=500: v*=3
    return max(5,int(v))
now=datetime.now(timezone.utc).replace(minute=0,second=0,microsecond=0)
start=now-timedelta(days=DAYS)
rows=[]; t=start
while t<=now:
    hour=t.hour
    factor=0.3+0.7*(1+random.random())*(1.0 if 9<=hour<=21 else 0.4)
    for _ in range(int(BASE_PER_HOUR*factor)):
        ts=t+timedelta(seconds=random.randint(0,3599))
        path=wpath(); status=pstatus(path,hour)
        method="GET" if path in ("/","/search","/products") else random.choice(METHODS)
        rows.append([ts.strftime("%Y-%m-%dT%H:%M:%SZ"),path,method,status,
                     platency(path,status),random.randint(200,20000),
                     random.choices(REGIONS,weights=[0.6,0.2,0.1,0.1])[0]])
    t+=timedelta(hours=1)
rows.sort(key=lambda r:r[0])
with open("access_logs.csv","w",newline="",encoding="utf-8") as f:
    csv.writer(f).writerows(rows)
print("生成完了 access_logs.csv 行数=",len(rows))
PYEOF
このスクリプトは、実際のWebサイトのアクセスログをまねたCSVを作ります。データには以下の特徴を持たせています。
- 昼間はアクセスが多く、深夜は少ない
- 深夜帯や決済ページ(
/checkout)などでエラーが起きやすい - 処理が重いページやエラーになったリクエストは、レスポンスタイムが長めになる
CSV の各列は、日時、パス、メソッド、ステータスコード、レスポンスタイム(ミリ秒)、レスポンスサイズ(バイト)、アクセス元の地域です。
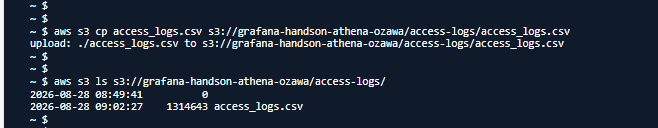
生成できたら、データバケットの access-logs/ にアップロードします。<YOUR_DATA_BUCKET> は自分のデータバケット名に置き換えてください。
aws s3 cp access_logs.csv s3://<YOUR_DATA_BUCKET>/access-logs/access_logs.csv
aws s3 ls s3://<YOUR_DATA_BUCKET>/access-logs/
Step2. Athena ワークグループを作成する
ワークグループは、Athena でクエリを実行するときの実行環境の単位です。今回は Grafana 専用のワークグループを1つ作成します。
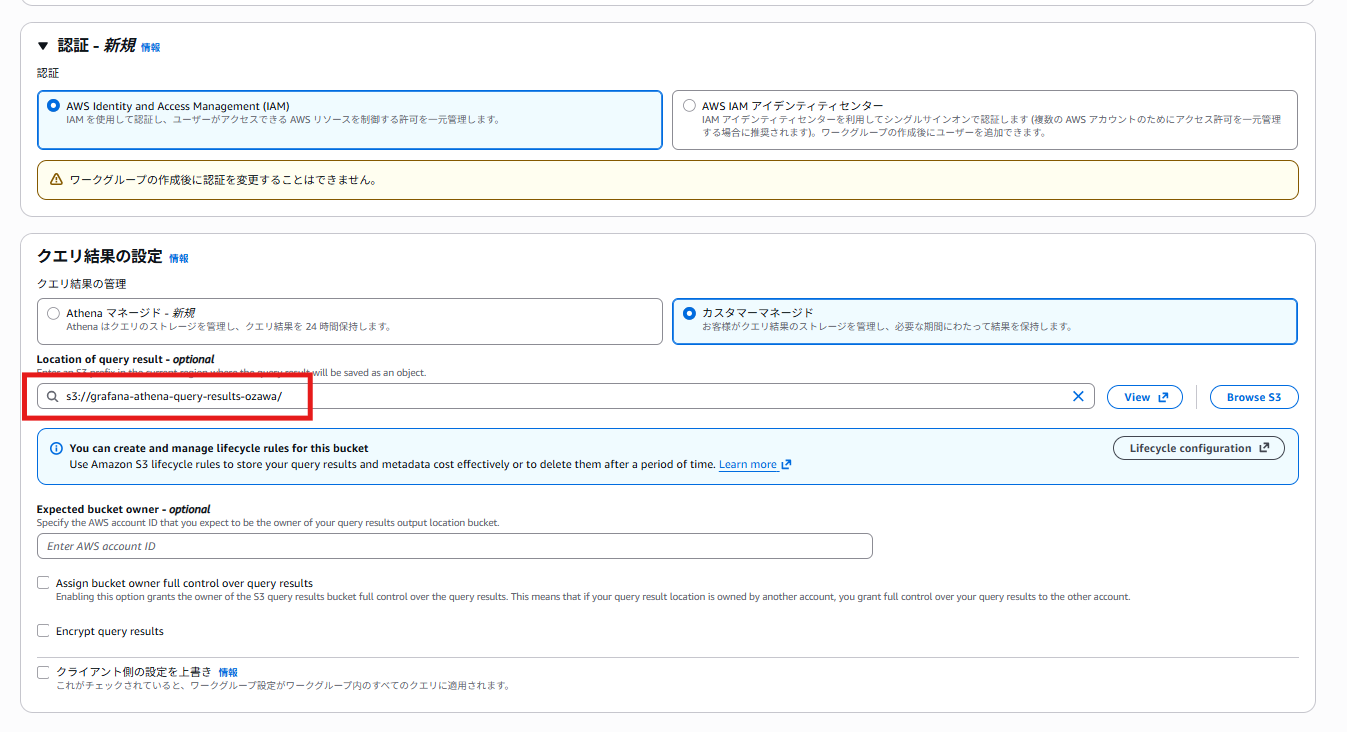
Athena コンソール → 管理 → ワークグループ → ワークグループを作成 で、以下のように作成します。
- 名前:
grafana - 認証: AWS Identity and Access Management (IAM)
- クエリ結果の管理: カスタマーマネージド を選び、結果の場所に Step1-2 で作った結果バケット(
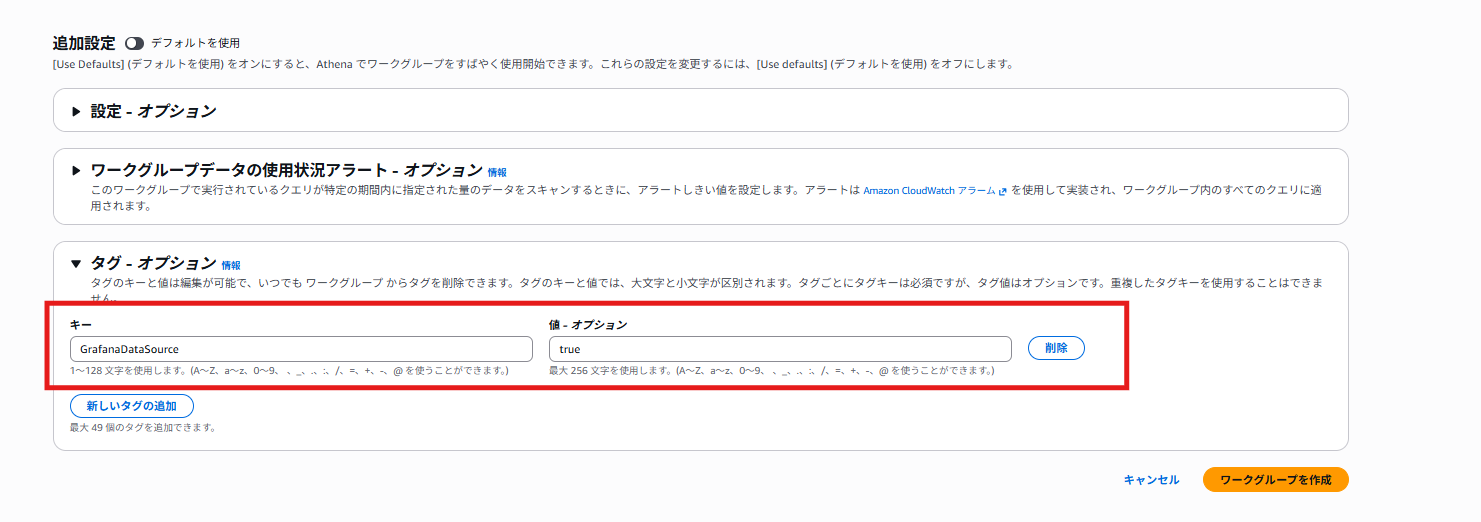
s3://grafana-athena-query-results-xxxx/)を指定 - タグ: キー
GrafanaDataSource/ 値true
Step3. Athenaでテーブルを作成し、データを確認する
S3 に置いた CSV を、Athena が SQL で読めるようにテーブル定義を作ります。
3-1. データベースとテーブルを作成する
Athena のクエリエディタで以下を順に実行します。まずデータベース:
CREATE DATABASE IF NOT EXISTS grafana_handson;
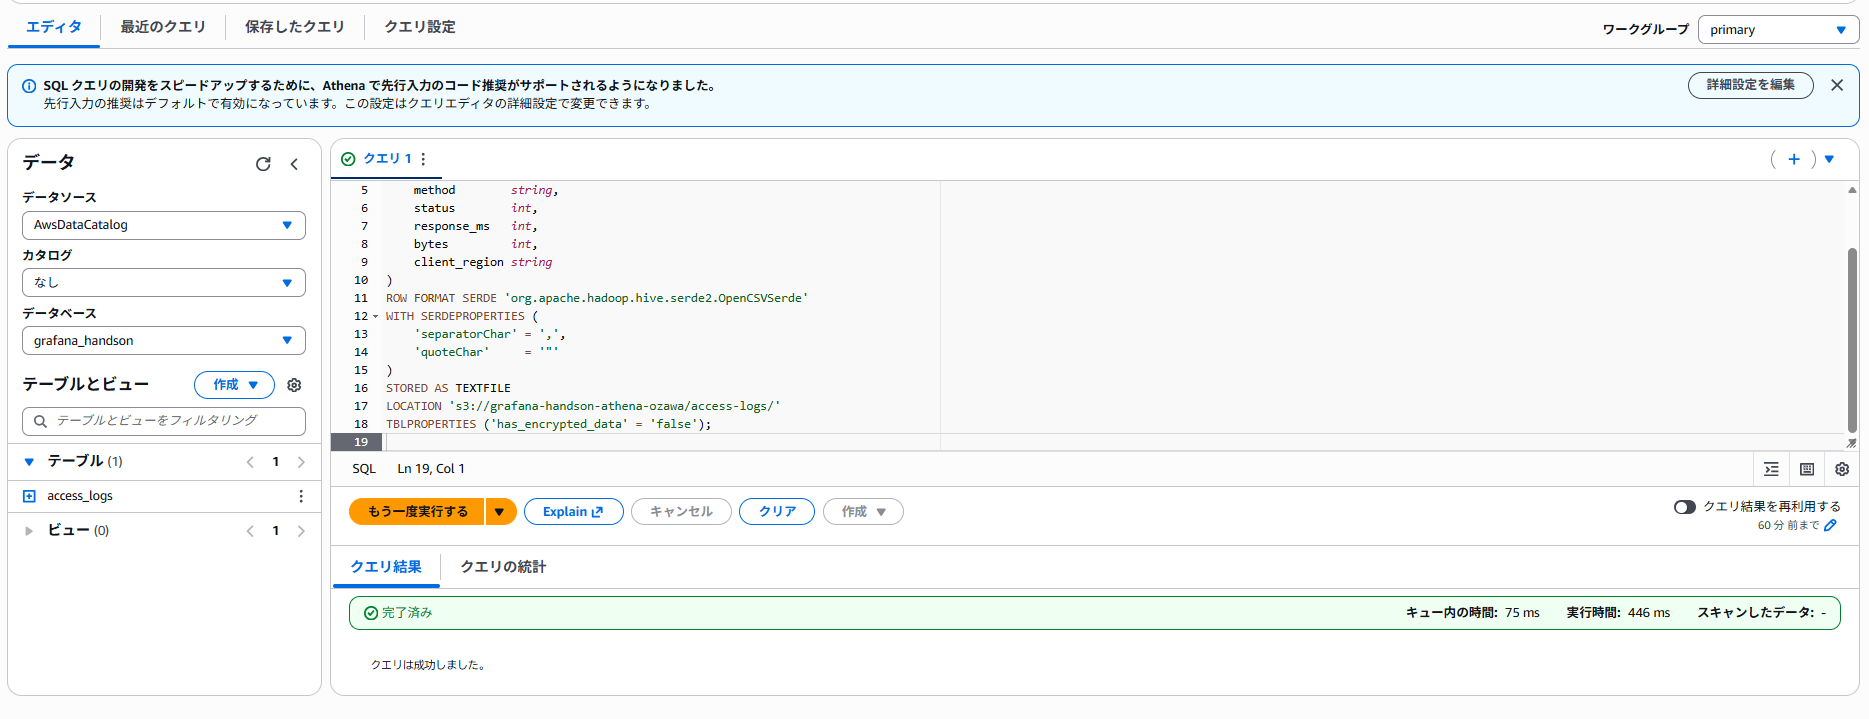
続いてテーブルを作成します。最後の LOCATION にある <YOUR_DATA_BUCKET> を、自分のデータバケット名に置き換えてから実行してください。
CREATE EXTERNAL TABLE IF NOT EXISTS grafana_handson.access_logs (
    ts            string,
    path          string,
    method        string,
    status        int,
    response_ms   int,
    bytes         int,
    client_region string
)
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.OpenCSVSerde'
WITH SERDEPROPERTIES (
    'separatorChar' = ',',
    'quoteChar'     = '"'
)
STORED AS TEXTFILE
LOCATION 's3://<YOUR_DATA_BUCKET>/access-logs/'
TBLPROPERTIES ('has_encrypted_data' = 'false');
このSQLのポイント:
CREATE EXTERNAL TABLE: データ本体は S3 に置いたまま、このCSVをどう読むかという定義だけを作ります- 列定義: CSVの各列を左から順にこの7列に割り当てます
OpenCSVSerde: CSVを読み解くためのパーサーLOCATION: 読み込み対象のS3フォルダ(ファイル単体ではなくフォルダを指定)
3-2. データが読めるか確認する
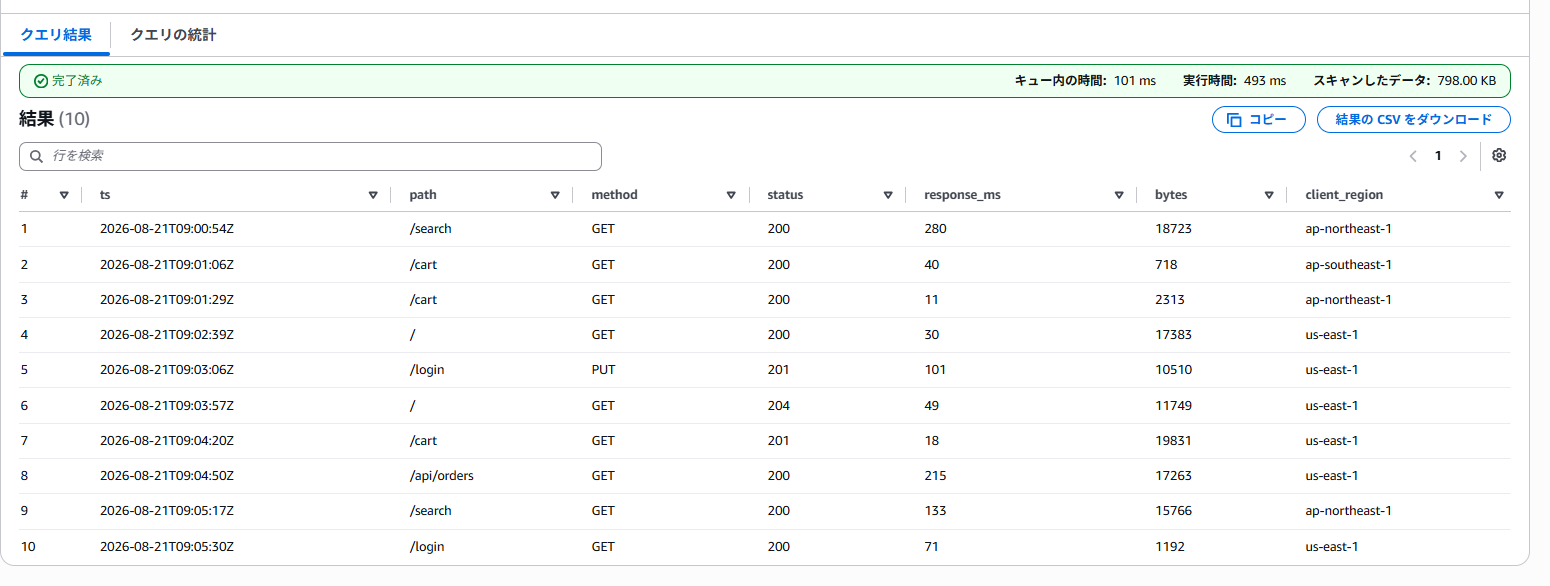
SELECT * FROM grafana_handson.access_logs LIMIT 10;
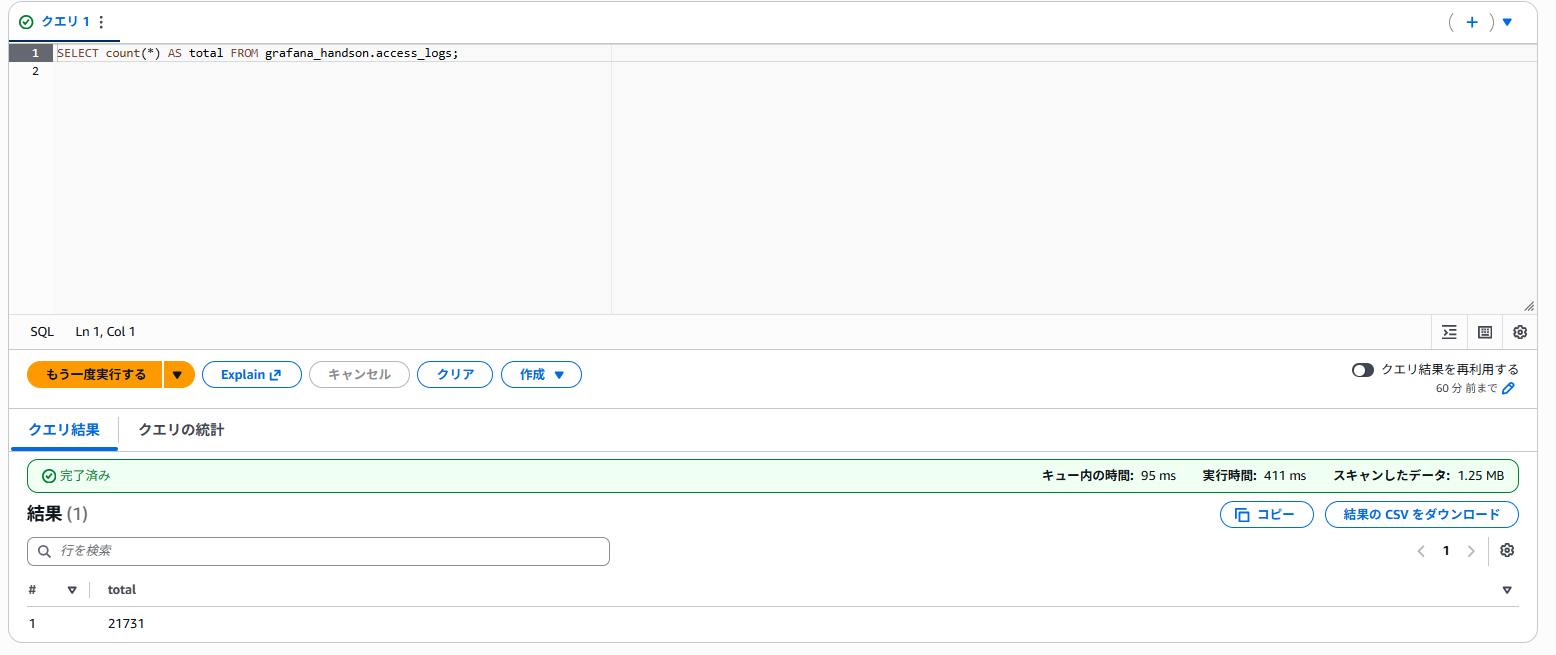
SELECT count(*) AS total FROM grafana_handson.access_logs;
件数がアップロードした行数と一致すれば成功です。
Step4. Amazon Managed Grafana ワークスペースを作成する
いよいよ可視化基盤を用意します。Grafana コンソールからワークスペースを作成を開き、ウィザードに沿って設定します。
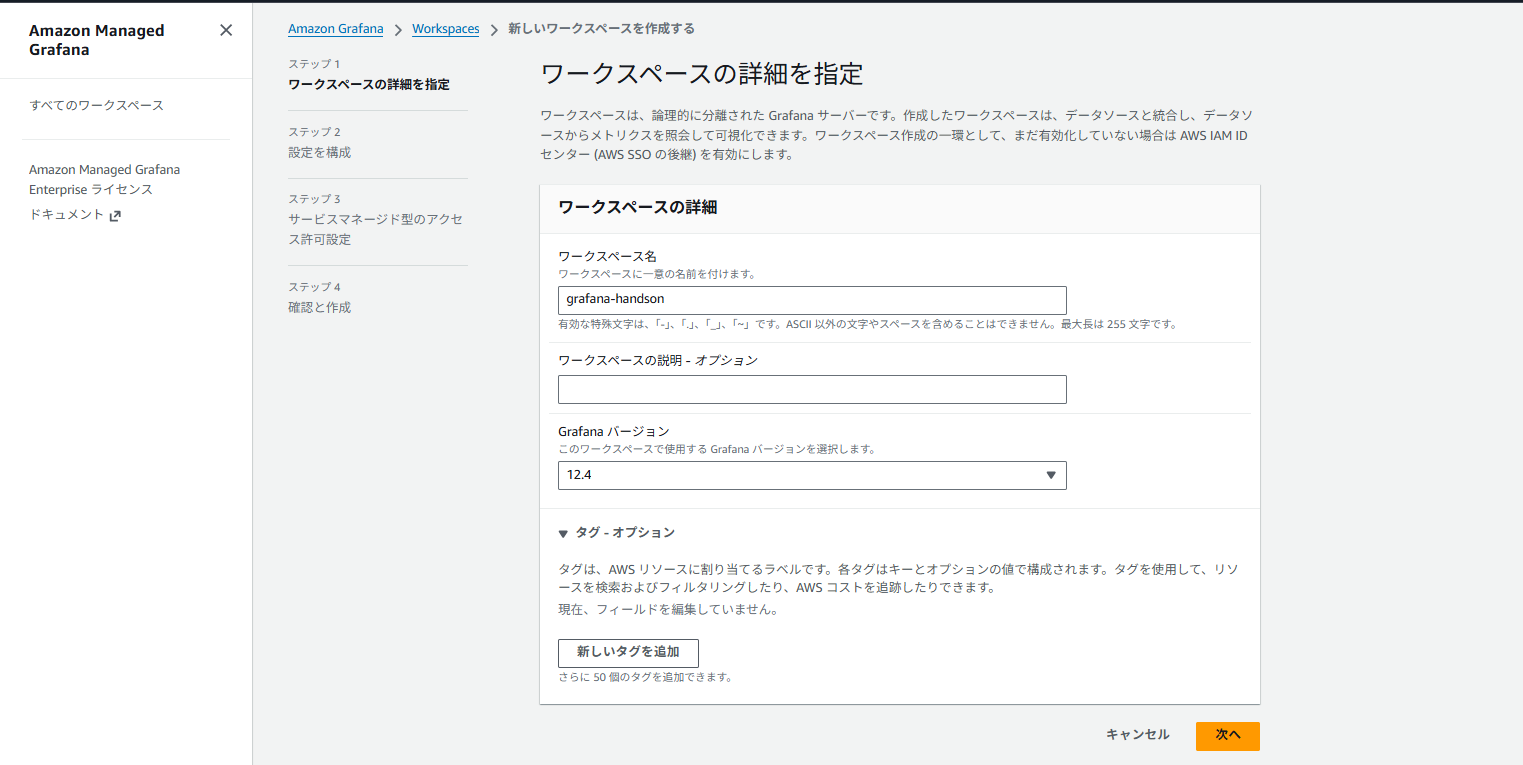
4-1. ワークスペース名を指定する
ワークスペース名は任意です。この記事では grafana-handson とします。
4-2. 認証方法を選ぶ
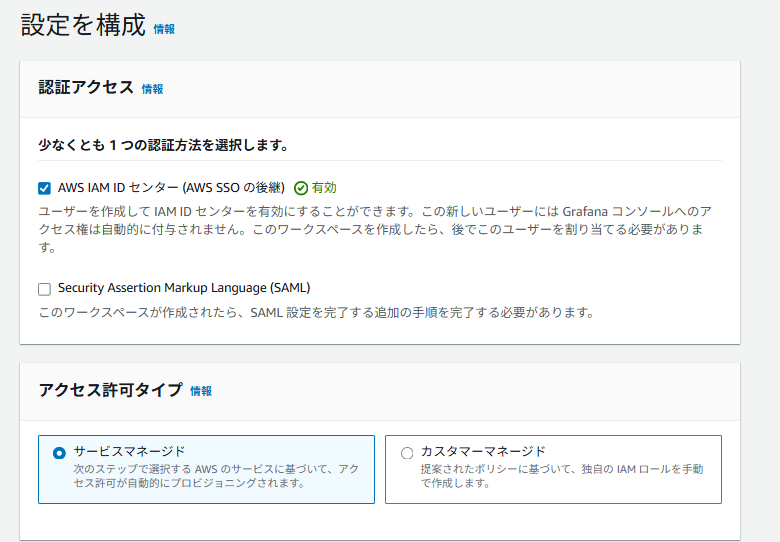
Grafana へのログイン方法を選びます。本記事では AWS IAM Identity Center を使います。社外の IdP と連携する場合は、必要に応じて SAML を選択してください。
4-3. アクセス許可を設定する
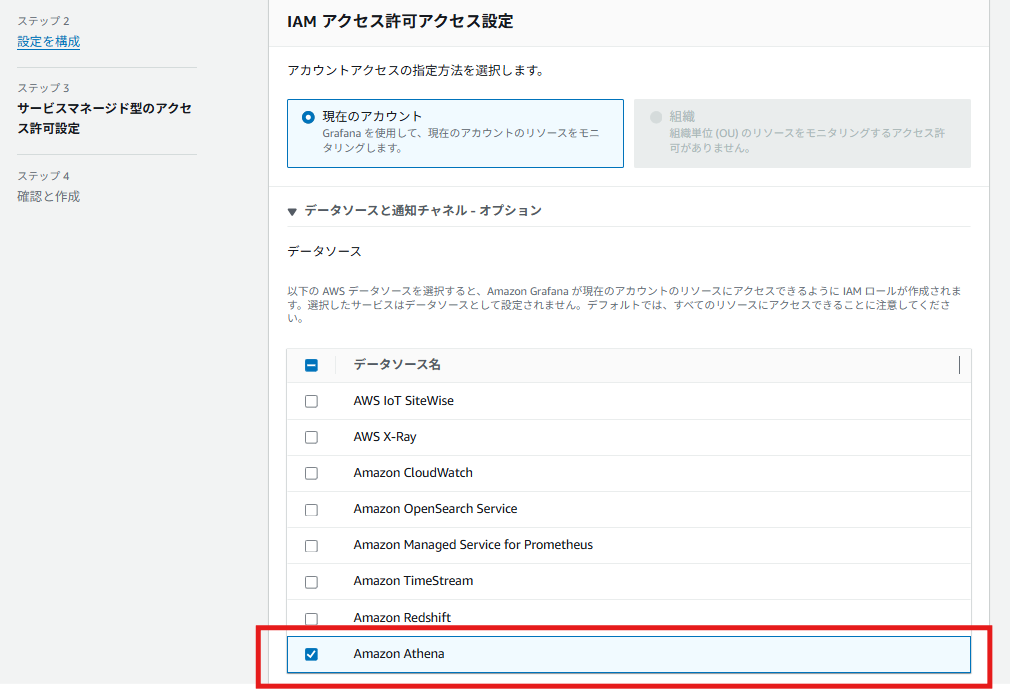
アクセス許可タイプは サービスマネージド を選択します。データソースは Amazon Athena にチェックを入れます。
4-4. 作成する
内容を確認してワークスペースを作成をクリックします。ステータスがアクティブになるまで数分待ちます。
(出典: ユーザー認証 / 最初のワークスペース作成)
Step5. ユーザーを割り当ててGrafanaにログインする
ワークスペースができても、そのままではまだログインできません。誰がログインできるかを割り当てる必要があります。
5-1. ユーザーを割り当てて管理者にする
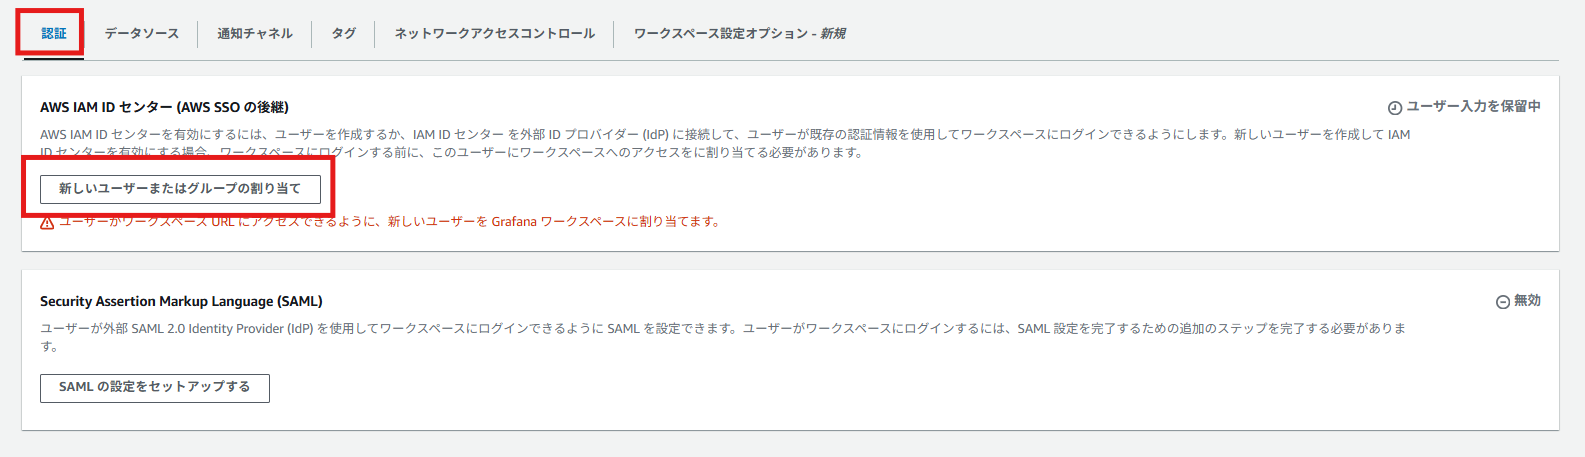
- ワークスペースの詳細画面で認証タブを開く
- IAM Identity Center のセクションで 新しいユーザーまたはグループの割り当て を選ぶ
- ログインさせたいユーザー(自分)を選んで割り当てる
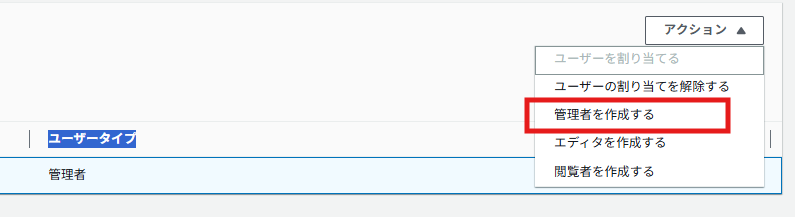
- 割り当てたユーザーを選択し、アクション → 管理者を作成する を選ぶ
- ユーザータイプが管理者になれば完了
5-2. Grafanaにログインする
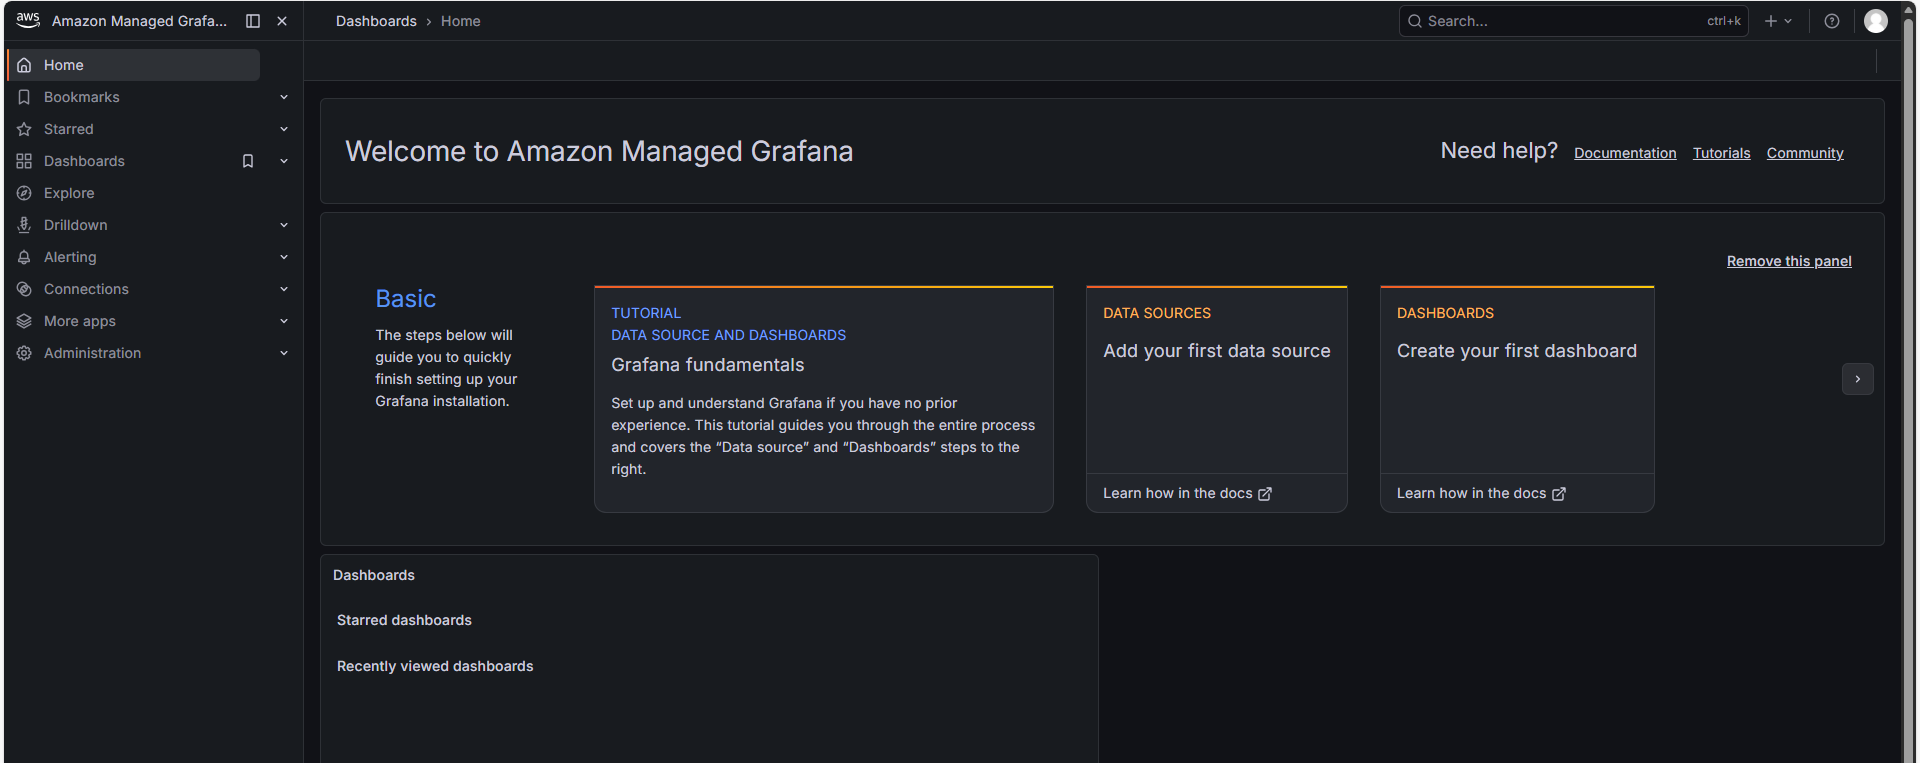
ワークスペースの詳細画面に表示されている Grafana の URL をクリックすると、IAM Identity Center のログイン画面が開きます。SSO のユーザー情報でログインすると、Grafana のホーム画面が表示されます。
Step6. Athenaデータソースを接続する
Grafana から Athena をデータソースとしてつなぐには、次の4つを順番に整えます。
- ワークスペースのプラグイン管理をオンにする
- Athena プラグインをインストールする
- ワークスペースの IAM ロールに Athena 用の権限を付ける
- データソースを作成して接続テストする
6-1. プラグイン管理をオンにする
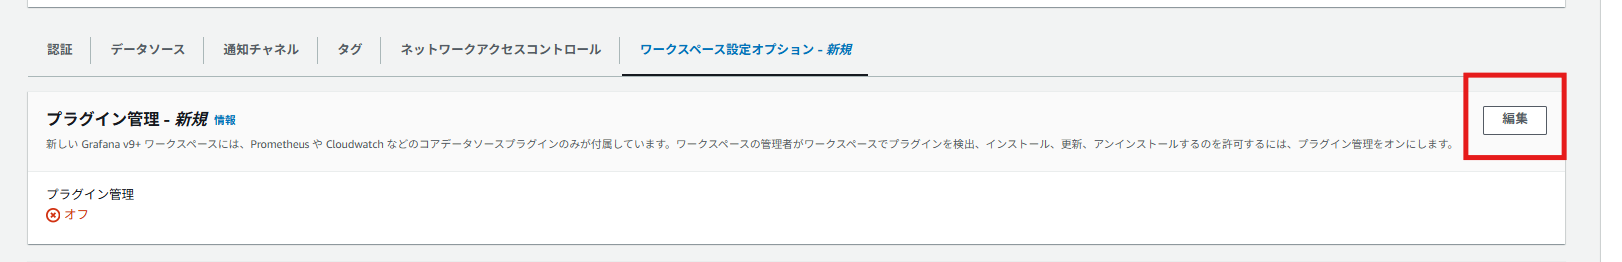
新しい Amazon Managed Grafana ワークスペースには、CloudWatch など一部のコアプラグインしか入っていません。Athena のような追加プラグインを使うには、まず プラグイン管理をオンにします。
- AWSコンソール → Amazon Managed Grafana → ワークスペース → ワークスペース設定オプション タブ
- プラグイン管理を編集してオンにして保存
(出典: プラグイン管理)
6-2. Athena プラグインをインストールする
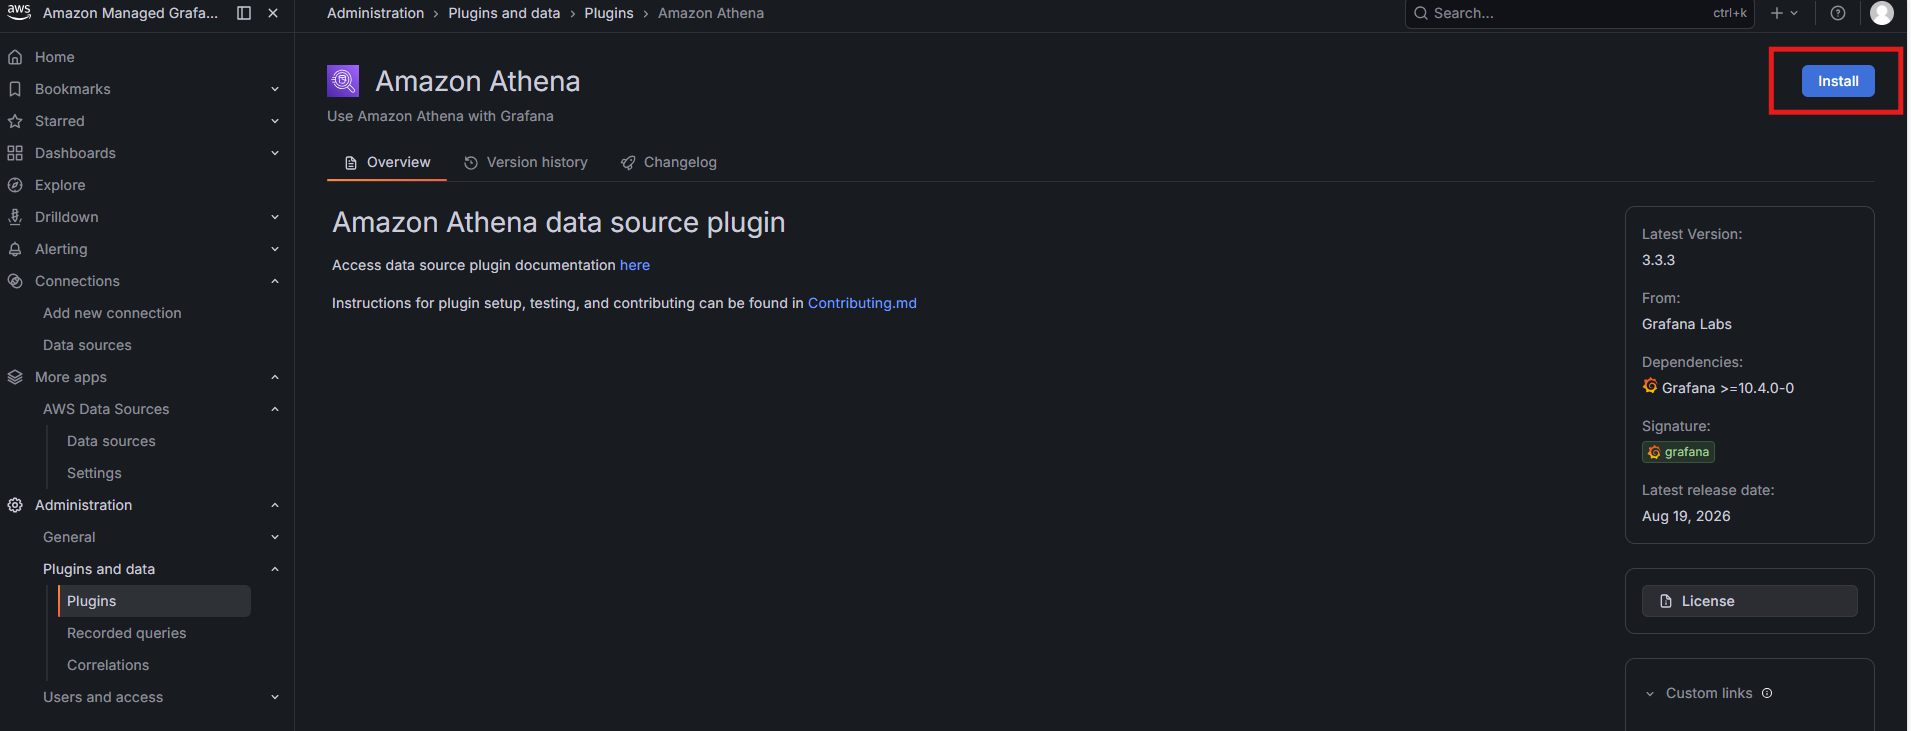
Grafana にログインし、Athena プラグインをインストールします。
- Grafana 左メニュー → Administration → Plugins and data → Plugins
- Amazon Athena を検索して開き、Install をクリック
6-3. IAM ロールに Athena 権限を付ける
Athena を使うには、Step4 で自動作成されたワークスペースの IAM ロール(AmazonGrafanaServiceRole-xxxx)に、権限が2つ必要です。
(A) AWS 管理ポリシー AmazonGrafanaAthenaAccess
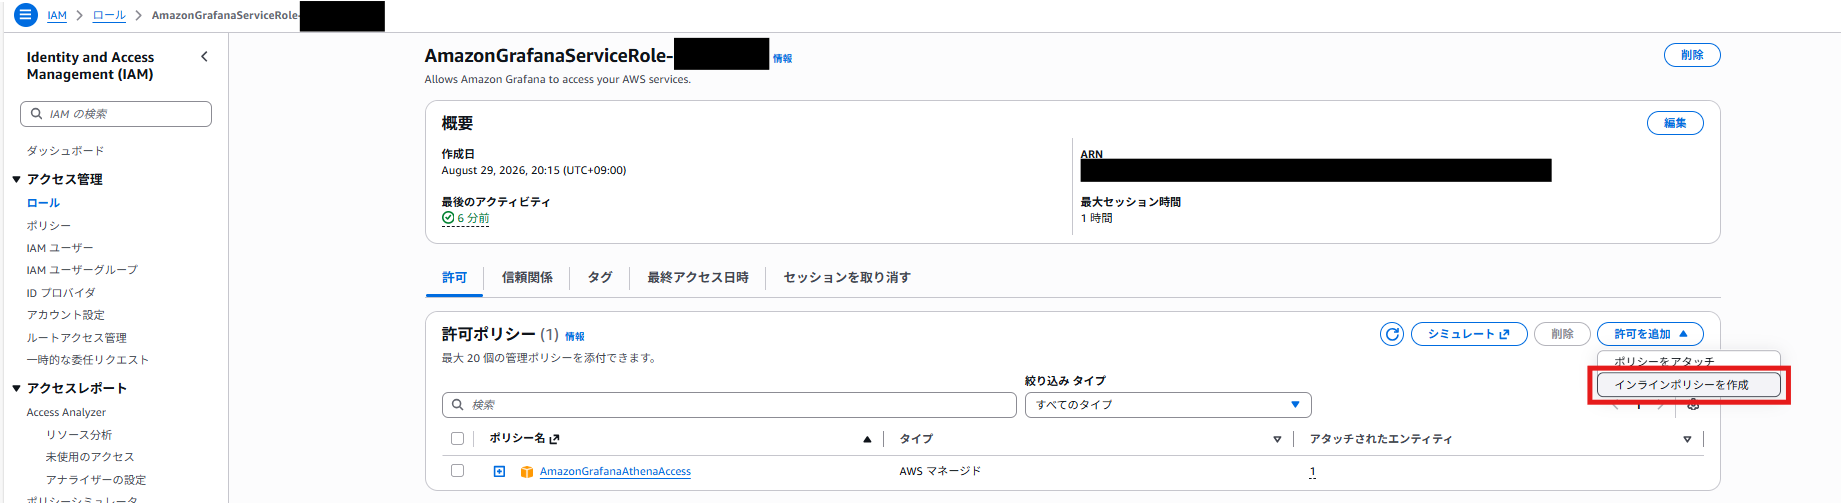
Step4-3 で Amazon Athena をチェックしていれば、このポリシーは自動でアタッチされています。IAMコンソールでロール AmazonGrafanaServiceRole-xxxx を開き、許可ポリシー一覧に含まれているか確認します。なければ 許可を追加 → ポリシーをアタッチ から付けます。
(B) データバケットの読み取り権限を追加する
AmazonGrafanaAthenaAccess にはデータバケットの読み取り権限が含まれないため、同じ IAM ロールに追加します。許可を追加 → インラインポリシーを作成 → JSON タブに以下を貼り付け、任意のポリシー名を付けて作成します。<YOUR_DATA_BUCKET>(2箇所)を自分のデータバケット名に置き換えてください。
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Sid": "GrafanaReadDataBucket",
            "Effect": "Allow",
            "Action": [
                "s3:GetObject",
                "s3:ListBucket",
                "s3:GetBucketLocation"
            ],
            "Resource": [
                "arn:aws:s3:::<YOUR_DATA_BUCKET>",
                "arn:aws:s3:::<YOUR_DATA_BUCKET>/*"
            ]
        }
    ]
}
(出典: Athena データソースの前提条件 / AmazonGrafanaAthenaAccess)
6-4. データソースを作成して接続テストする
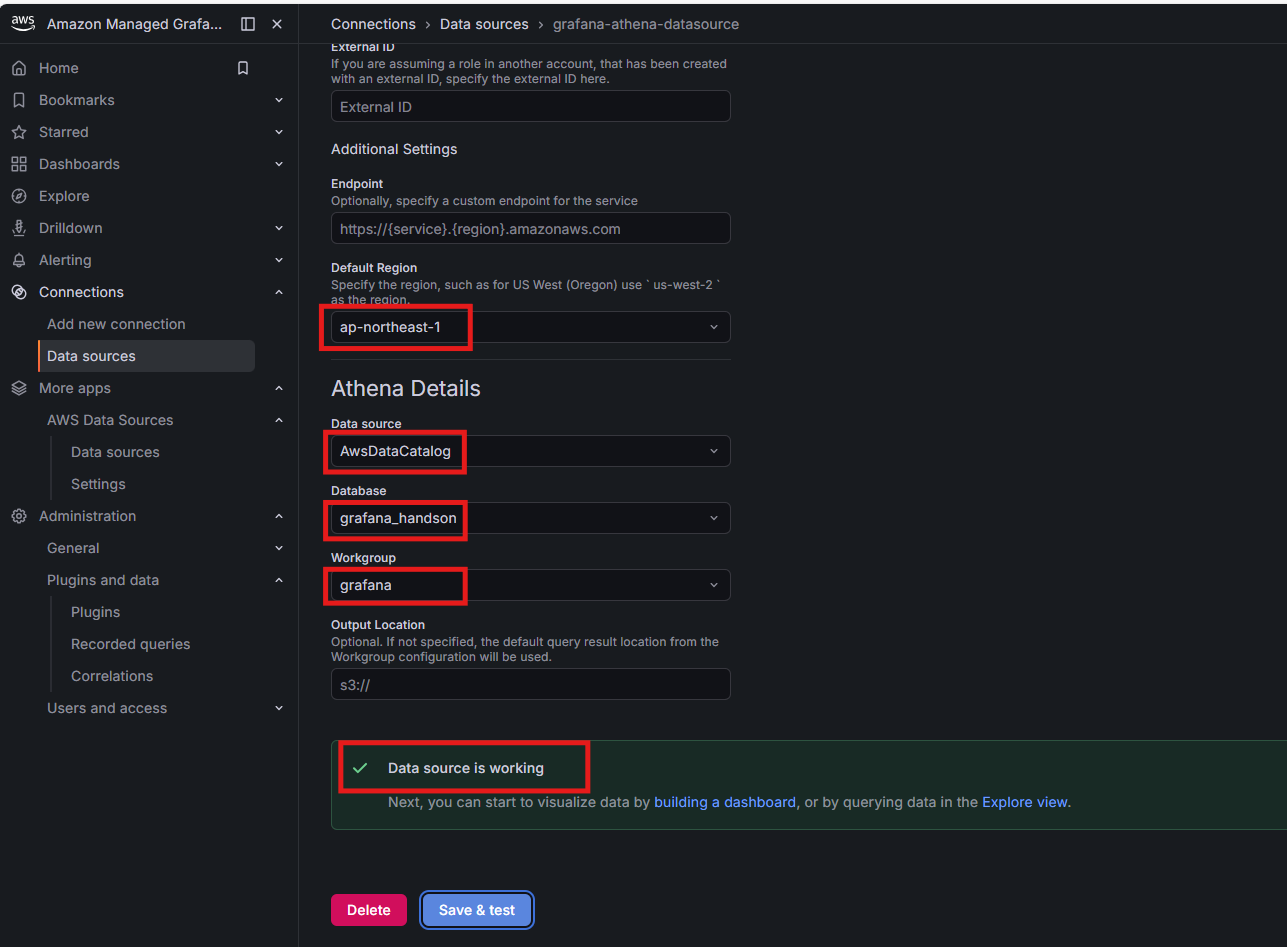
Grafana の左メニュー → Connections → Data sources → Add data source を開き、一覧から Amazon Athena を選んで以下を設定します。
| 項目 | 設定値 |
|---|---|
| Authentication Provider | Workspace IAM Role |
| Default Region | ap-northeast-1 |
| Data source(カタログ) | AwsDataCatalog |
| Database | grafana_handson(Step3 で作ったデータベース) |
| Workgroup | grafana(Step2 で作ったもの) |
| Output Location | 空欄(ワークグループの設定が使われる) |
Save & test をクリックして Data source is working と出れば成功です。
前編のまとめ
前編では、S3 にサンプルデータを置き、Athena でクエリできるようにして、Amazon Managed Grafana に Athena をデータソースとして接続するところまでを行いました。ここまでで、S3 のデータを Grafana から扱う準備が整いました。
接続ができたので、いよいよ後編では、このデータを使ってダッシュボードを作っていきます。
(後編へ続く)
参考リンク(出典)
- Amazon Managed Grafana 料金: https://aws.amazon.com/grafana/pricing/
- 組み込みデータソース: https://docs.aws.amazon.com/grafana/latest/userguide/AMG-data-sources-builtin.html
- Athena データソースの前提条件: https://docs.aws.amazon.com/grafana/latest/userguide/Athena-prereq.html
- AmazonGrafanaAthenaAccess(AWS管理ポリシー): https://docs.aws.amazon.com/grafana/latest/userguide/security-iam-awsmanpol.html
- プラグイン管理: https://docs.aws.amazon.com/grafana/latest/userguide/grafana-plugins.html
最後まで読んでいただきありがとうございました!
この記事は私が書きました
小澤 陽童
記事一覧