
- 公開日
- 最終更新日
AWS FISで疑似障害を起こしてみた
この記事を共有する


目次
パーソル&サーバーワークスの高橋です。
本記事では、AWS Fault Injection Service(以下、AWS FIS)を使ってEC2にCPU負荷をかけ、CloudWatchアラームが発火してAuto Scalingが狙いどおりにスケールアウトするかを確認していきます。
なお、本記事では構成図やソースコードは掲載せず、FISの設定手順と検証結果を中心にご紹介します。
はじめに
AWS FISは、AWS上のワークロードに意図的に障害を発生させ、システムの回復力(レジリエンス)を検証するためのマネージドサービスです。いわゆる「カオスエンジニアリング」を、AWSのマネジメントコンソールから手軽に実践できます。
主な特徴は次のとおりです。
- 豊富なアクション:EC2の停止やCPU負荷、ネットワーク遅延、RDSのフェイルオーバーなど
- 柔軟なターゲット指定:対象のリソースをタグなどで指定できる
- 停止条件:CloudWatchアラームを設定でき、想定外の影響が出たら実験を自動で止められる
- 料金:アクションの実行時間に応じた従量課金
前提
以下の環境は構築済みとします。リージョンは東京(ap-northeast-1)です。
■ EC2・Auto Scaling
- Auto Scalingグループ:最小2台・希望2台・最大3台
- EC2:t3.micro、Amazon Linux 2023
- IAMロール:AmazonSSMManagedInstanceCore(Systems Managerで管理できる状態)
- タグ:FIS-Target = true(FISの対象を絞り込むために使用)
■ CloudWatchアラーム(Auto Scalingグループ全体の平均で判定)
- cpu-high:平均CPUが70%を超えた状態が2分続いたら、1台スケールアウト
- cpu-low:平均CPUが30%を下回った状態が5分続いたら、1台スケールイン
- fis-stop-condition:稼働中(InService)のEC2が2台を下回ったらALARM(FISの停止条件として使用)
なお、スケールアウトとスケールインは、上記のcpu-high/cpu-lowアラームに紐づけたステップスケーリングポリシー(1台ずつ増減)で行っています。
【安全装置】 3つ目のfis-stop-conditionは、実験の安全装置として用意したアラームです。今回はCPU負荷をかけるだけなので、本来EC2の台数は減りません。そのため「稼働中のEC2が2台(=最小台数)を下回る」のは想定外の異常事態といえます。このアラームをFISの停止条件に指定しておくことで、万一そうなった場合に実験が自動で止まるようにしています。正常に進めば発火しないアラームです。
想定する動きは「通常2台 → CPU負荷で3台にスケールアウト → 負荷終了後に2台へ戻る」です。
FISの作成
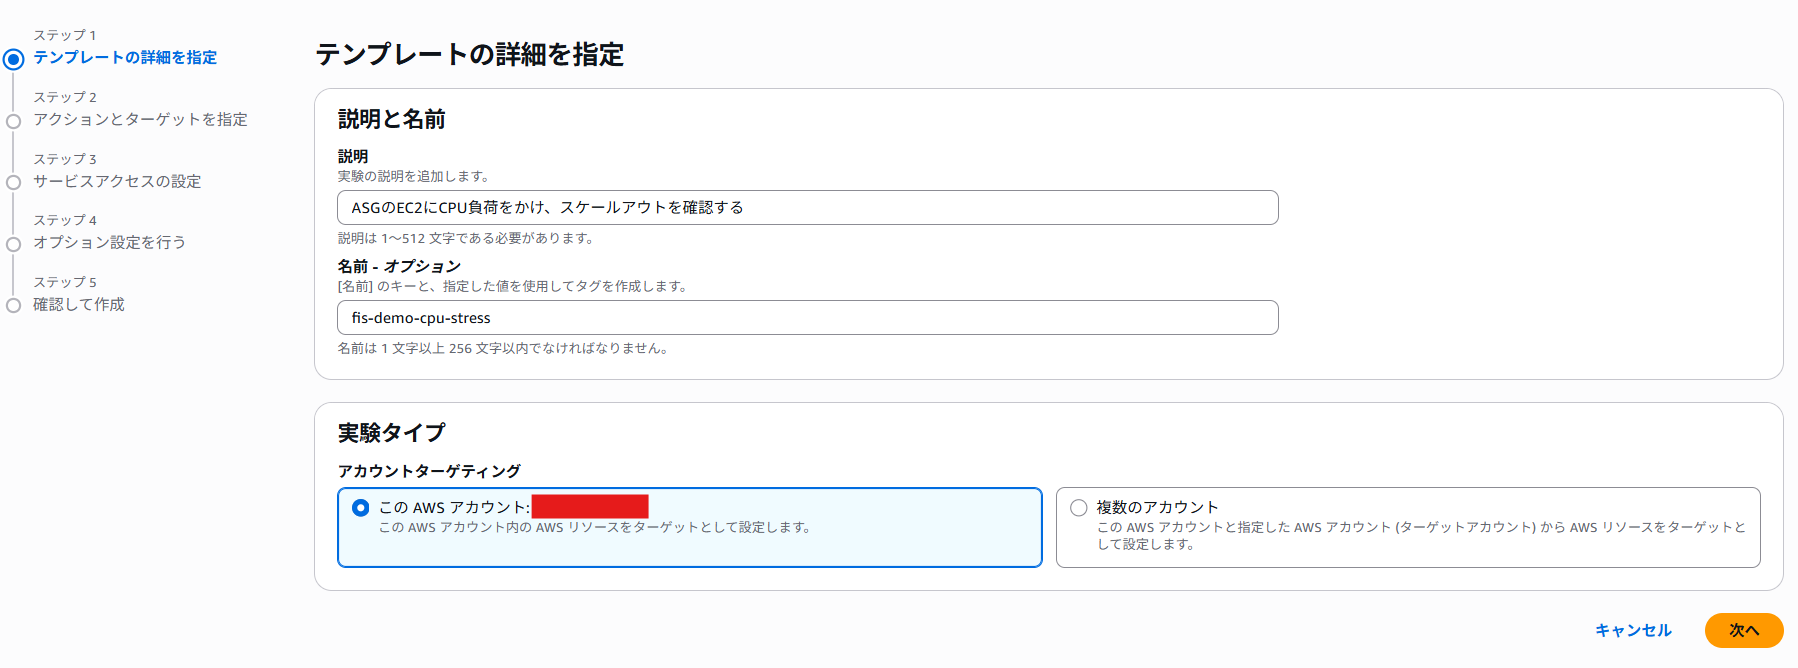
1. テンプレートの詳細を指定
左メニューの「回復力のテスト」>「実験テンプレート」から「実験テンプレートを作成」を押下し、以下を設定します。
- 説明:任意(例:ASGのEC2にCPU負荷をかけ、スケールアウトを確認する)
- 名前:任意(例:fis-demo-cpu-stress)
- アカウントターゲティング:このAWSアカウント
2. アクションを追加
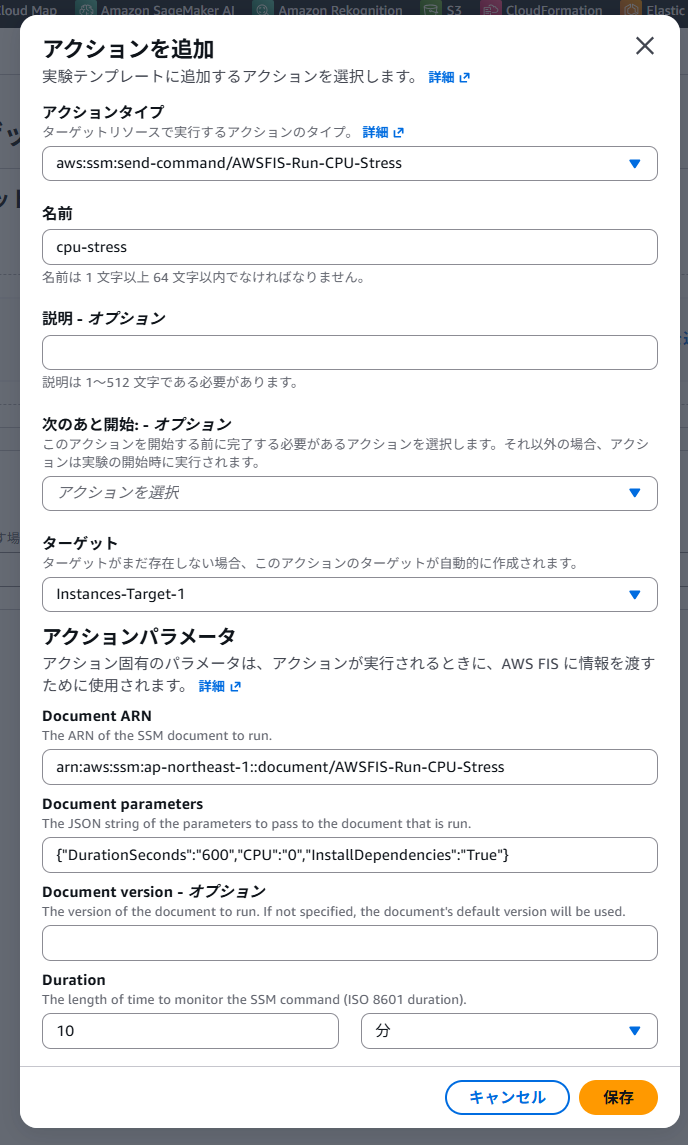
「アクションを追加」から、以下のように設定します。
- アクションタイプ:aws:ssm:send-command/AWSFIS-Run-CPU-Stress
- 名前:cpu-stress
- 次のあと開始:空欄(実験の開始と同時に実行)
- ターゲット:Instances-Target-1(自動で作成されます)
- Document parameters:以下のJSONを入力
- Duration:10分(Document parametersのDurationSecondsと同じか、それより長くする)
アクションタイプの「AWSFIS-Run-CPU-Stress」は、SSM Run Commandを使ってEC2の中でCPU負荷ツールを実行するアクションです。
■ Document parametersに入力する値
{"DurationSeconds":"600","CPU":"0","InstallDependencies":"True"}
- DurationSeconds:負荷をかける秒数(600秒=10分)
- CPU:負荷をかけるvCPUの数(0はすべてのvCPU)
- InstallDependencies:負荷ツール(stress-ng)が入っていなければ自動でインストールする
負荷時間を10分にしているのは、アラームの評価(2分)、EC2の起動、ウォームアップを含めて、スケールアウトの完了まで確認できるようにするためです。
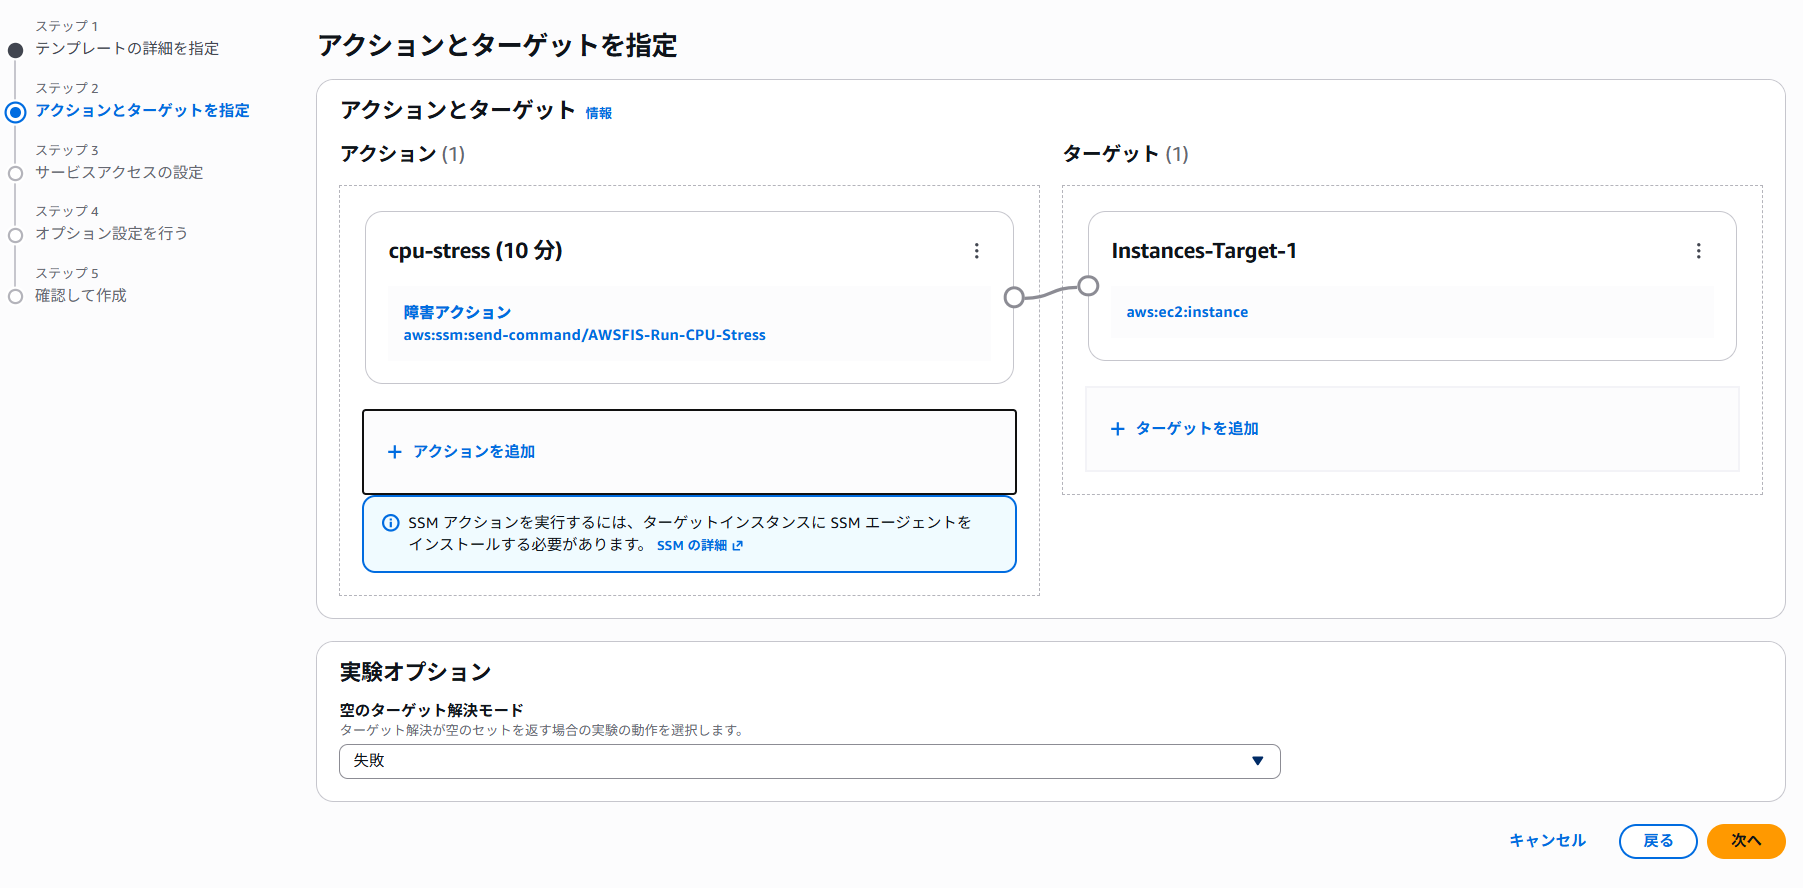
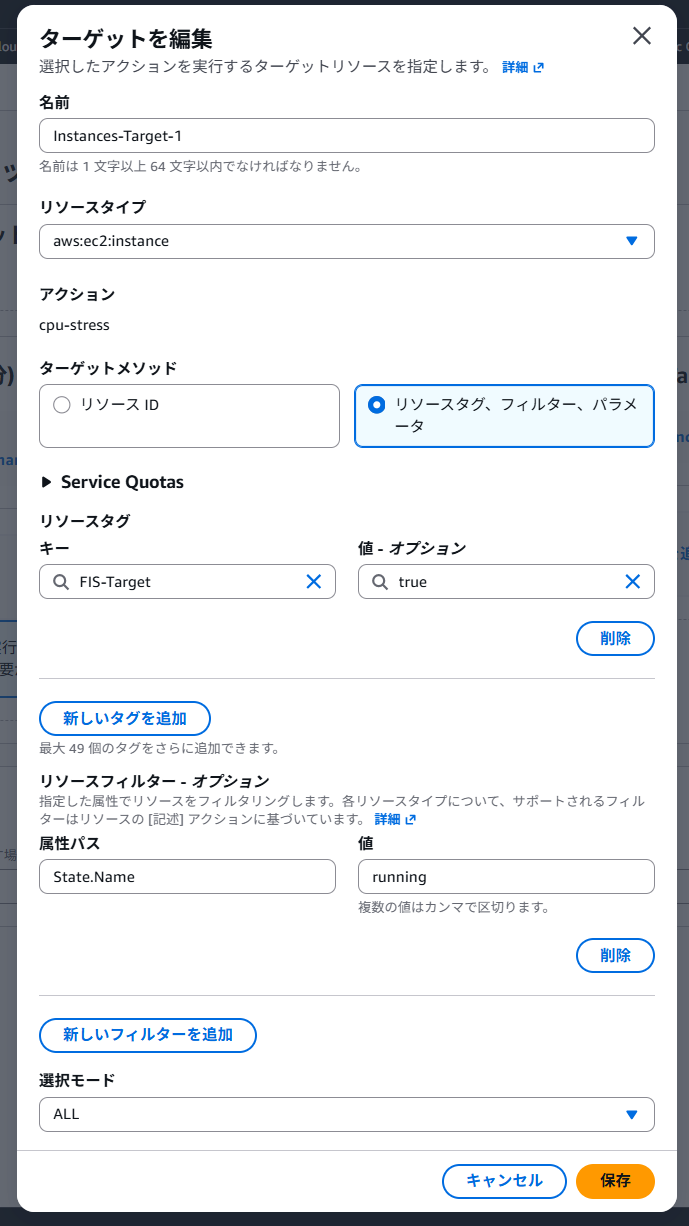
3. ターゲットを編集
アクションを保存すると、ターゲット「Instances-Target-1」が自動で作成されます。ターゲットの右上にある「三つの点」から「編集」を選択します。
ターゲットは以下のように設定します。
- リソースタイプ:aws:ec2:instance
- ターゲットメソッド:リソースタグ、フィルター、パラメータ
- リソースタグ:キー「FIS-Target」、値「true」
- リソースフィルター(属性パス):State.Name
- リソースフィルター(値):running(起動中のインスタンスのみを対象にする)
- 選択モード:ALL(条件に一致するインスタンスすべてを対象にする)
4. サービスアクセスの設定
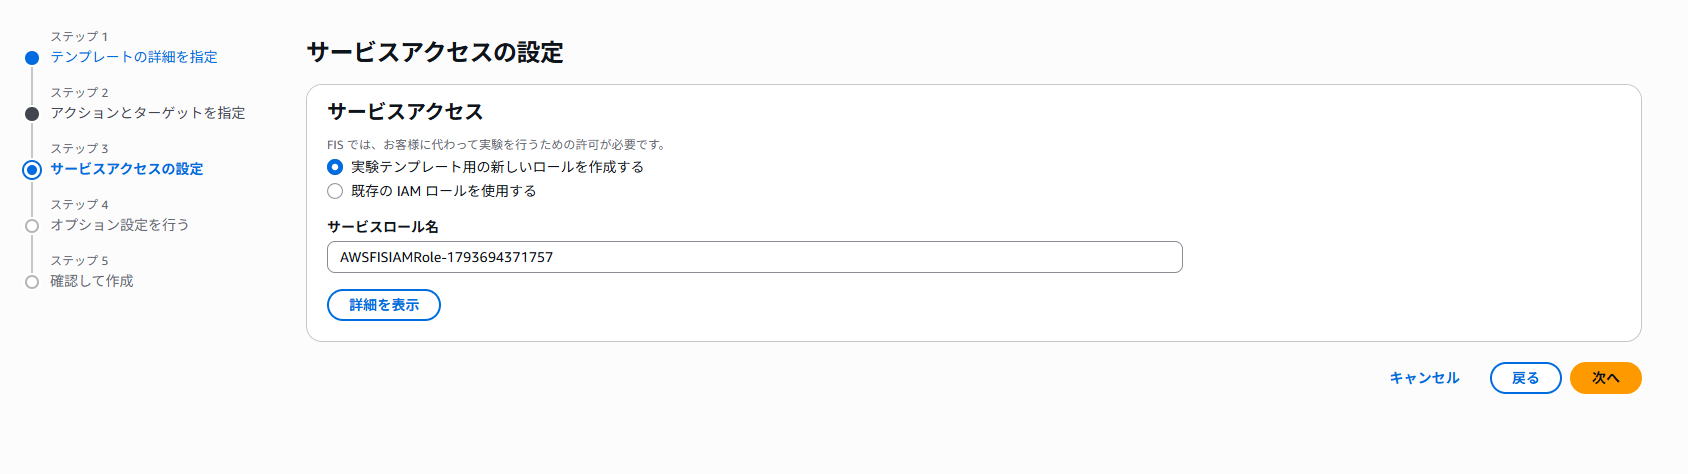
- サービスアクセス:実験テンプレート用の新しいロールを作成
- サービスロール名:自動で入力された名前のまま
選択したアクションに必要な権限を持つIAMロールが、自動で作成されます。
5. オプション設定
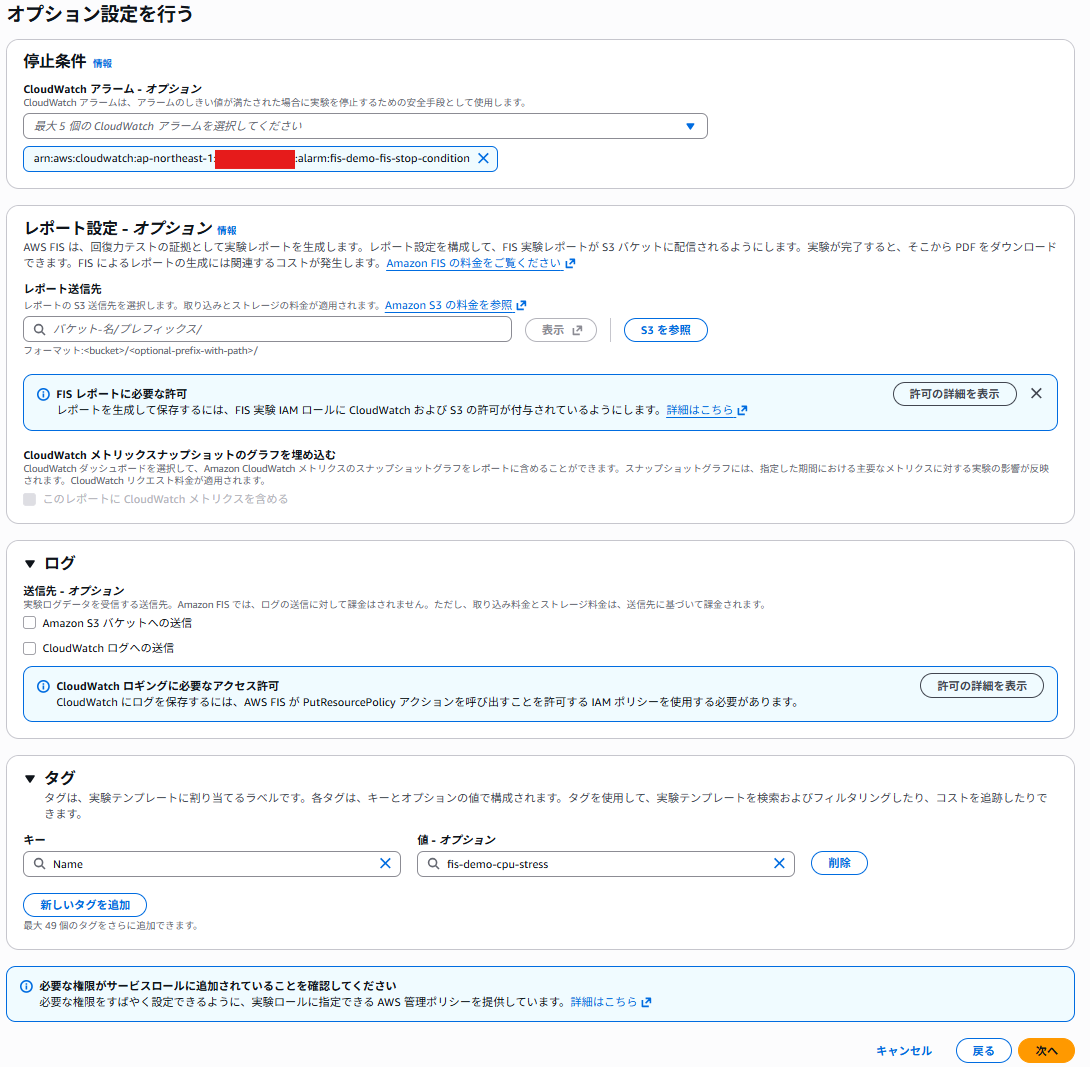
オプションは以下のように設定します。
- 停止条件:fis-demo-fis-stop-condition
- レポート設定:今回は設定なし
- ログ:今回は設定なし
- タグ:Name = fis-demo-cpu-stress
【ポイント】 停止条件には、稼働中の台数が2台を下回ったらALARMになるアラームを指定しています。万一、実験の影響でEC2が減ってしまった場合でも、実験が自動で止まる安全装置になります。
レポート設定では実験結果をPDFレポートとしてS3に出力でき、ログではS3やCloudWatch Logsに実験ログを出力できます。今回はどちらも使いません。
6. 確認して作成
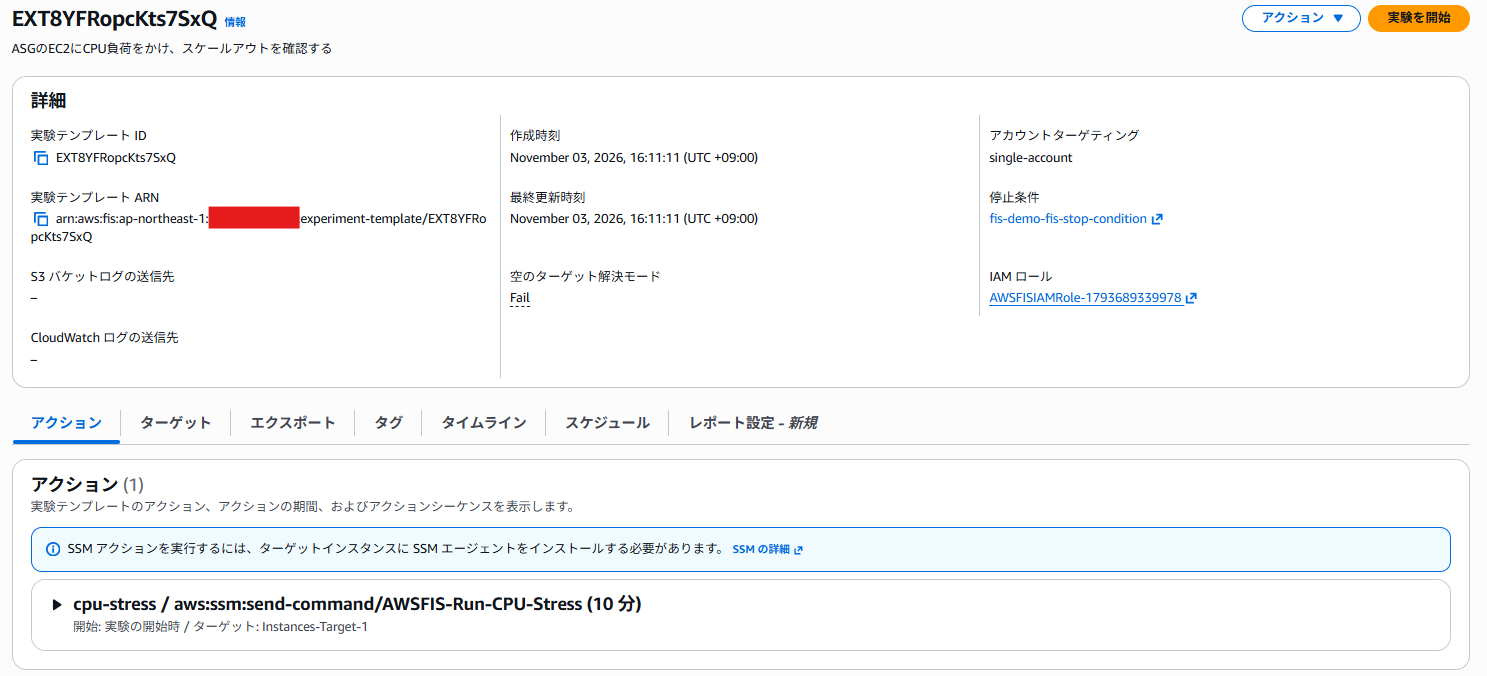
設定内容を確認し、問題がなければ「実験テンプレートを作成」を押下します。
実験の実行
① 実験を開始する
作成した実験テンプレートの画面右上から「実験を開始」を押下します。
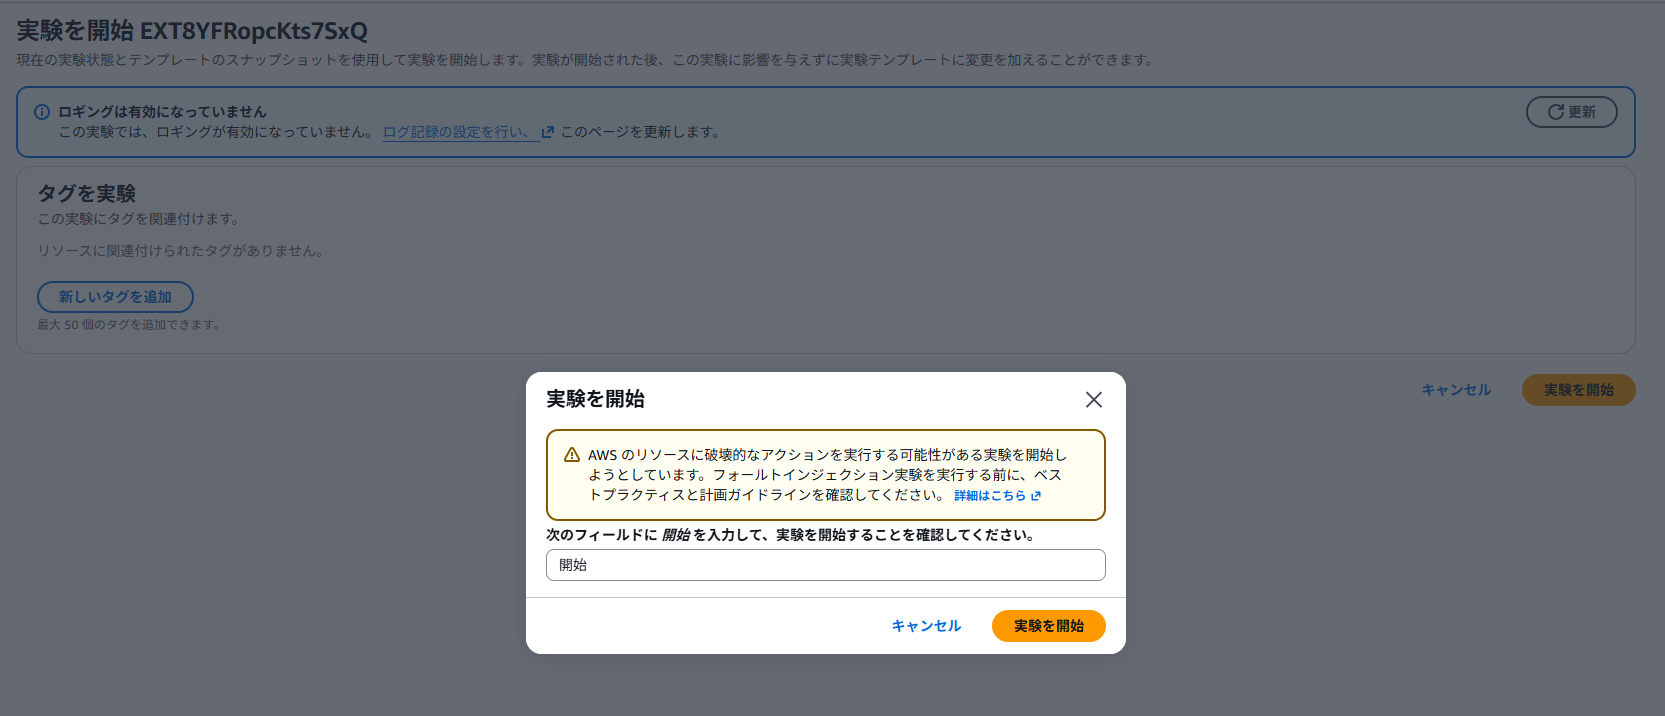
② 確認ダイアログに入力する
確認ダイアログが表示されるので、入力欄に「開始」と入力し、「実験を開始」を押下します。
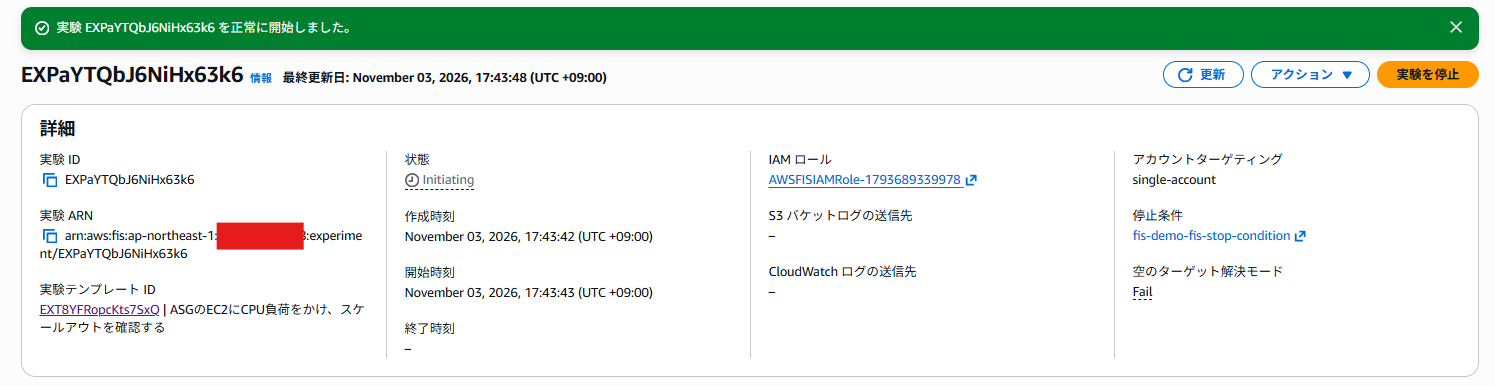
③ 実験の状態を確認する
「実験を正常に開始しました」と表示されます。実験の状態は「Initializing」から始まり、少し待つと「Running」に変わります。
結果
EC2の台数
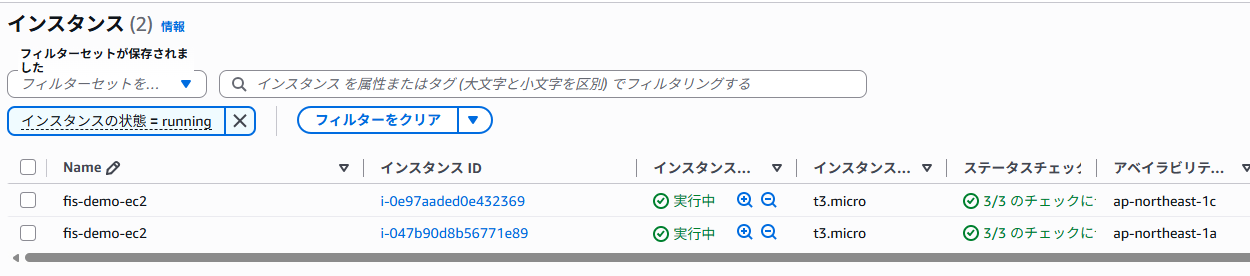
■ 実験前:2台
Auto Scalingグループの希望台数どおり、EC2が2台(ap-northeast-1aと1cに1台ずつ)起動しています。
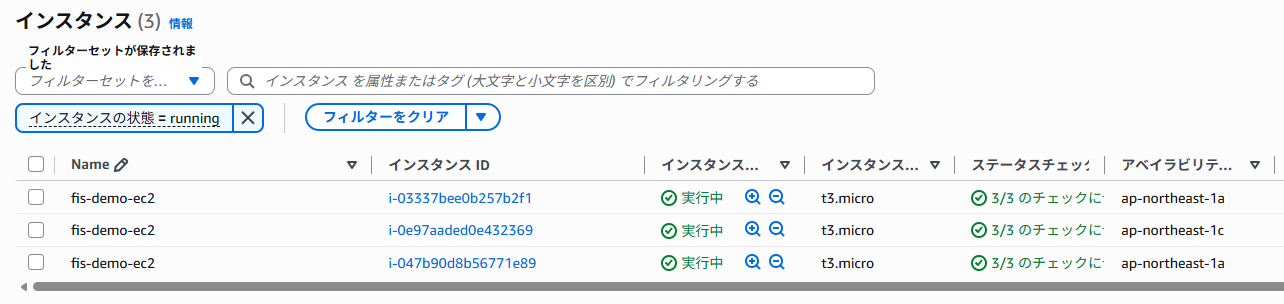
■ 実験中:3台に増加
CPU負荷によってアラームが発火し、EC2が1台(ap-northeast-1a)追加されました。最大台数の3台でスケールアウトが止まっています。
CloudWatchの確認
CloudWatchダッシュボードでも、挙動を確認しました。
- CPU使用率:実験開始(16:54ごろ)の直後から上昇し、約2分で100%に達した
- cpu-high:しきい値(70%)を超えた状態が続き、ALARM状態になった
- fis-stop-condition:OKのままで、実験は停止されずに継続した
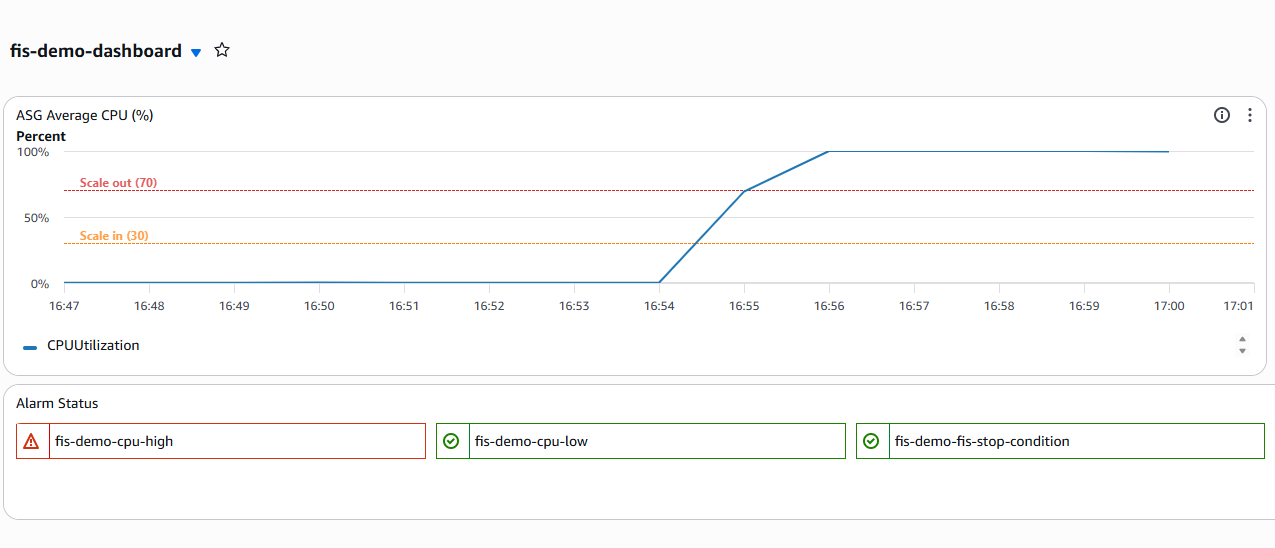
【結論】 「CPU負荷 → CloudWatchアラームの発火 → Auto Scalingによるスケールアウト」という一連の流れが、狙いどおりに動作することを確認できました。
まとめ
今回は、AWS FISを使ってEC2にCPU負荷をかけ、CloudWatchアラームとAuto Scalingが想定どおりに動作するかを確認しました。
FISを使うと、負荷ツールを自分でインストールしたりスクリプトを書いたりしなくても、マネジメントコンソールの操作だけで疑似障害を発生させられます。また、CloudWatchアラームを停止条件に設定しておけば、想定外の影響が出たときに実験を自動で止められるため、安全に検証を進められます。
「アラームのしきい値は適切か」「スケールアウトは期待どおりの台数で止まるか」といった設定は、実際に負荷をかけてみないと確認しづらいポイントです。本番環境に適用する前の確認手段として、ぜひFISを活用してみてください。
最後までお読みいただき、ありがとうございました。
参考
- What is AWS Fault Injection Service?(AWS公式ドキュメント)
- AWS FIS actions reference(アクション一覧/AWS公式ドキュメント)
- Stop conditions for AWS FIS(停止条件/AWS公式ドキュメント)
- Run CPU stress on an instance(CPU負荷のチュートリアル/AWS公式ドキュメント)
- AWS Fault Injection Service の料金(AWS公式)
この記事は私が書きました
高橋 憲太
記事一覧パーソル&サーバーワークスの高橋です。 猫も犬も好きです。
